KI-Entwicklertools · Was kam heute
Für eine erfahrene Engineerin, die ohnehin HN liest. Echte Veränderungen bei KI-Entwicklertools heute: Releases mit Versionsnummern, Paper mit Benchmarks, Repos, die eine relevante Schwelle überschritten haben. Hype-Threads, Pre-Announcement-Leaks und recycelte Zusammenfassungen überspringen. Immer Originalquellen verlinken.
EmbeddingGemma 2, Beam 501B, Pyrefly – drei Releases mit Zahl
EmbeddingGemma 2
Google shreddert die On-Device-Embedding-Hierarchie.
EmbeddingGemma 2 ist ein 740-Millionen-Parameter-Modell, das Text, Bilder, Audio und Video in einem einheitlichen Vektorraum kombiniert [Quelle: Google]. Es toppt MTEB und MAEB für seine Größe und lädt auf dem Pixel 11 Pro mit 567 MB komplett ins RAM. Matryoshka Representation Learning spart bis zu 6× Speicher ohne Qualitätsverlust; der 8K-Token-Kontext schlägt bisherige On-Device-Grenzen.
Die Apache-2.0-Lizenz macht es zur Commodity – LiteRT, MediaPipe und transformers.js bauen es bereits ein.
Reflection Beam 501B
501 Milliarden Parameter, 23 aktiv – Mixture-of-Experts trifft Coding-Spezialist.
Reflection AI veröffentlichte Beam am 5. Oktober: ein auf 24 Billionen Token trainiertes MoE-Modell mit 1-Million-Token-Kontext, das auf SWE-bench Verified (80,9) und Terminal-Bench v2.1 (80,1) konkurrenzfähig mit chinesischen Modellen wie GLM-5.2 läuft [Quelle: shattered.io]. Die Effizienz-Architektur soll Inferenz-Kosten deutlich senken, aber TechCrunch betont: unabhängige Verifizierung steht noch aus. Vollständige Gewichte folgen im Oktober unter Apache 2.0.
Das Unternehmen (gegründet 2024 von ex-DeepMind-Leadern, Nvidia-Investor, 25B Bewertung) schiebt Open-Source-Coding jenseits der Single-GPU-Welt.
Pyrefly bei Google
Google zieht seinen Python-Type-Checker aus und setzt Metas Pyrefly ein.
Nach über einem Jahrzehnt mit Pytype wechselt der Konzern zu Pyrefly, einem in Rust geschriebenen Open-Source-Tool, das 97% Konformität mit der offiziellen Typing-Suite erreicht [Quelle: Google Open Source Blog]. Inkrementelle Rebuilds sind bis zu 98% schneller; bei großen ML-Targets sank die Type-Check-Zeit von Minuten auf Sekunden. Google spart über 80% der täglichen Peak-Compute-Auslastung für Python-Type-Checking.
Der Wechsel ist ein Statement: Performance schlägt Internal-Only.
ALoDLM – adaptive Rekurrenz
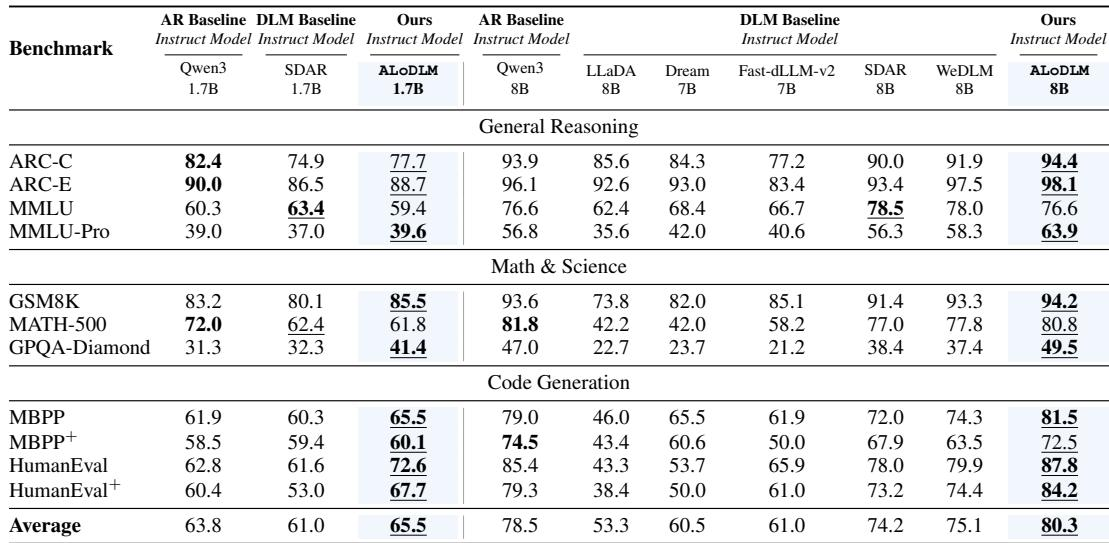
Diffusions-Sprachmodelle mit token-adaptiven Schleifen schlagen Autoregression.
ALoDLM (University of Illinois Chicago, Amazon AGI, Korea U.) verteilt Rechenressourcen je nach Token-Schwierigkeit und erreicht 2,7× höheren Durchsatz als vLLM-basierte Qwen3-8B bei vergleichbarer Genauigkeit [Quelle: arXiv]. Das 1,7B und 8B-Parameter-Modell toppt alle evaluierten Diffusions-Baselines über elf Benchmarks. Parallele Dekodierung plus adaptive Rechenplanung ohne umfangreiche Retrainung.
Diffusions-Dekoding wird zur produktiven Alternative – Latenz trifft Quality.
 EmbeddingGemma 2: an open, lightweight multimodal embedding ...11 hours ago ... Storage-efficient: Using Matryoshka Representation Learning (MRL) ... Developer tools. Build real-time voice applications with Gemini 3.8 Live and ...blog.google
 Reflection AI Beam: 501-Mrd.-Modell im Test [2026] - shattered.io16 hours ago ... Marktauswirkungen auf Entwickler-Tools und IDEs. Für Anbieter von KI-Coding-Tools wie GitHub Copilot, Cursor oder JetBrains-Produkten verändert ein ...shattered.io
 ALODLM: Diffusions-Sprachmodelle mit adaptiven Schleifen | Paper10 hours ago ... Refer to the framework diagram for an overview of the decoding process. ... Von der Idee bis zum Launch – beschleunigen Sie Ihre KI-Entwicklung mit ...hyper.ai
 Adopting Pyrefly as the Python type checker at Google9 hours ago ... Python is one of the primary languages at Google, powering everything from machine learning research to developer infrastructure and data pipelines. Across ...opensource.googleblog.com
Mehr aus Tech
- Senior AI EngineeringLass alles weg, was nach Pressemitteilung oder Marketing klingt. Gehe auf die neuesten Entwicklungen ein, die als Senior Software Engineer wichtig sind: Bspw. neue LLM Modelle, wirklich neue Tools und Frameworks zur AI Entwicklung und Best Practices.Lesen
- Software Engineering with AI AgentsLatest news about AI, AI Coding, Best Practices, New Models, Anthropic Releases, Expected new models. Focus on advanced techniques and consider that I am a Senior Software Engineer with a lot of experience. Focus on advanced techniques on how I can improve my coding workflow & stay up to date.Lesen
- KI-Produktmanagement · Branchen-BriefingDie drei wichtigsten Stories, die KI-Produktmanagement heute prägen, geschrieben für jemanden, der bereits in der Branche arbeitet: Regulierung, M&A, neue Marktteilnehmer, wichtige Filings und Präzedenzfälle. Fachpublikation (z.B. Fachpresse, Behördenquelle, Gerichtsakten) direkt zitieren, damit ich nachrecherchieren kann.Lesen
- IT-Sicherheit · Branchen-BriefingDie drei wichtigsten Stories, die IT-Sicherheit heute prägen, geschrieben für jemanden, der bereits in der Branche arbeitet: Regulierung, M&A, neue Marktteilnehmer, wichtige Filings und Präzedenzfälle. Fachpublikation (z.B. Fachpresse, Behördenquelle, Gerichtsakten) direkt zitieren, damit ich nachrecherchieren kann.Lesen