Du wirst angemeldet...

Bitte warte, während wir deine Anmeldung überprüfen

Artikel · Dienstag, 22. September 2026

KI-Entwicklertools · Was kam heute

Für eine erfahrene Engineerin, die ohnehin HN liest. Echte Veränderungen bei KI-Entwicklertools heute: Releases mit Versionsnummern, Paper mit Benchmarks, Repos, die eine relevante Schwelle überschritten haben. Hype-Threads, Pre-Announcement-Leaks und recycelte Zusammenfassungen überspringen. Immer Originalquellen verlinken.

Von Marius BongartsTech67 Ausgaben
← Zur aktuellen Ausgabe
Ausgaben
2 / 67
Über Nacht von KI aus öffentlichen Quellen erstellt, täglich aktualisiert.
KI-Entwicklertools · Was kam heute
Dienstag, 22. September 2026
KI-Entwicklertools · Was kam heute

Claude 5.1 mit 25% Kostensenk; BullshitBench misst Nonsense-Ablehnung; Nemotron Modelle offengefallen

1 Min. Lesezeit

Claude Fable & Mythos 5.1

Anthropics Doppelschlag spart Geld und knackt Benchmarks.

Claude Fable 5.1 kostet etwa 25% weniger als die Vorgängerversion bei typischen Workloads – durch 75% niedrigere Cache-Read-Preise (jetzt 0,25 Dollar pro Million Tokens) – bei agentengesteuerten Aufgaben sinken die Kosten um bis zu 45% [Quelle: Anthropic]. Die Performance-Sprünge sind größer: 73,4% auf CursorBench 3.2.0 (agentic coding), 65,0% auf Humanity's Last Exam mit Tools. Claude Mythos 5.1 erreicht beim Protein-Design Hit-Rates um 50% – deutlich über dem branchenüblichen 10–15%.

Biotech-Anwendungen treffen nun Produktionsreife.

BullshitBench v2 Live

Neue Messlatte: Können Modelle Unsinn erkennen?

Das BullshitBench-Projekt bietet jetzt ein v2-Dashboard mit 100 Fragen und 21.400 Antworten über 214 Modell-Reasoning-Kombinationen – bewertet von einer Jury aus Claude Sonnet 4.6, GPT-5.2 und Gemini 3.1 Pro Preview [Quelle: GitHub]. DeepSeek V4.1 Flash, Claude Fable 5.1 und GPT-6 Astra sind neu dabei. Das Benchmark misst, wie gut Modelle Nonsense-Prompts ablehnen, statt sie selbstbewusst zu beantworten – eine critique der LLM-Tendenz, alles irgendwie zu beant­worten.

Honesty wird messbar.

Nvidias Modell-Trio offengefallen

Nemotron und Cosmos: Effiziente Architekturen im Open.

Nemotron 3.5 Lightning (30B total, 3B aktiv) mit Hybrid-Mamba-2-Transformer nutzt 1M-Token-Fenster und erreicht 86% auf PinchBench – 30% schneller als Konkurrenz [Quelle: Hugging Face]. Nemotron 3 Super (120B / 12B aktiv) und 3 Ultra (550B / 55B aktiv) bringen 5× höheren Durchsatz für Multi-Agenten-Workflows. Cosmos 3 Reihe (Super 32B, Nano 8B, Edge 4B) öffnet Physical-AI-Modelle; RAG-Stack erweitert sich um Parse v1.2, Embedding und Reranking [Quelle: NVIDIA Developer].

Agentenentwickler kriegen jetzt offene Werkzeuge in voller Breite.

LLM-unterstützte Klausurbewertung akademisch validiert

Lehrkräfte behalten Kontrolle über KI-Bewertung.

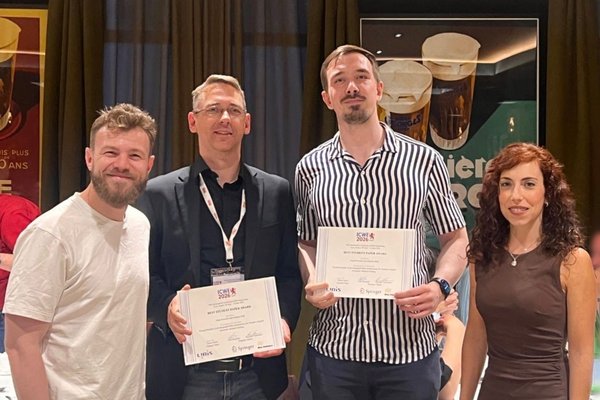
Jonas Gwozdz und Prof. Andreas Both gewannen den Best Student Paper Award der ICWE 2026 für eine Architektur, die Sprachmodelle in Lehrkontext einsetzt – das Modell wird dabei systematisch an die Bewertungskriterien der Lehrkraft ausgerichtet [Quelle: HTWK Leipzig]. In der besten Konfiguration erreichte das System 91% Übereinstimmung mit manuellen Bewertungen, getestet auf echten anonymisierten Prüfungsdaten – der Durchbruch für vertrauenswürdige Automatisierung im Education-Sektor.

KI-Benotung wird akademisch verortet.
Quellen
Introducing Claude Fable 5.1 and Claude Mythos 5.1 - Anthropic
4 hours ago ... A new performance frontier. Claude Fable 5.1 sets a new standard for coding ... It's the first time a frontier model like Claude has empowered us to explore new ...
anthropic.com
KI-Zusammenfassung

Anthropic released Claude Fable 5.1 and Claude Mythos 5.1, positioning them as the world's most advanced models for coding and knowledge work. Fable 5.1 achieves approximately 25% lower costs than Fable 5 for typical workloads through reduced cache read pricing (now $0.25 per million tokens, a 75% reduction), with savings up to 45% for highly agentic tasks. The model demonstrates significant performance improvements across multiple benchmarks: Terminal-Bench-Science 0.1 (52.6%), Terminal-Bench 4.0 (60.9% for Mythos 5.1), Humanity's Last Exam (65.0% with tools), and CursorBench 3.2.0 (73.4%), outperforming Fable 5 and competitor models. Mythos 5.1, available through trusted access programs, shows advanced capabilities in scientific research including protein design with hit rates near 50% across 12 targets and computational biology optimizations achieving up to 2.5x speedup on GPU models.

Quelle öffnen
petergpt/bullshit-benchmark: BullshitBench measures ... - GitHub
22 hours ago ... The new dashboard is now the default viewer. The latest completed results ... Model/reasoning variants, Responses. V1, 55, 194, 10,670. V2, 100, 214, 21,400 ...
github.com
KI-Zusammenfassung

DeepSeek V4.1 Flash, Claude Fable 5.1 and GPT-6 Astra wurden in das BullshitBench Benchmark aufgenommen, das misst, wie gut Modelle Nonsense erkennen und ablehnen. Das V2-Benchmark umfasst 100 Fragen mit 214 Modell-/Reasoning-Varianten und 21.400 Antworten, bewertet von einer Jury aus Claude Sonnet 4.6, GPT-5.2 und Gemini 3.1 Pro Preview. Das aktualisierte Dashboard wurde am 10. September 2026 als Standard-Viewer zur Verfügung gestellt.

Quelle öffnen
nvidia - Hugging Face
3 hours ago ... Nemotron 3 Nano \- A new Standard for Efficient, Open, and Intelligent Agentic Models ... Evaluate model performance, Nemotron Eval & Benchmark Collection, SPEED- ...
huggingface.co
KI-Zusammenfassung

Nemotron 3.5 Lightning wurde mit einer hybriden Mamba-2- und Transformer-MoE-Architektur (30B gesamt / 3B aktive Parameter) veröffentlicht und bietet ein 1M-Token-Kontextfenster mit spekulativen Dekodierungsmodi. Nemotron 3 Super mit 120 Milliarden Parametern (12 Milliarden aktiv) nutzt LatentMoE und Multi-Token-Prediction und liefert 5x höheren Durchsatz als die vorherige Version. Nemotron 3 Ultra, ein 550B-Modell (55B aktiv), wurde für komplexe Multi-Agenten-Anwendungen optimiert. Im RAG-Stack wurden Nemotron Parse v1.2, Llama Nemotron Embed VL 1B v2 und Llama Nemotron Rerank VL 1B v2 veröffentlicht. Cosmos 3 Super (32B), Cosmos 3 Nano (8B) und Cosmos 3 Edge (4B) wurden als offene omni-Modelle für Physical AI freigegeben. Dazu kommen offene Trainingsdatensätze aus der Nemotron Datasets Collection für Pretraining, Math-Reasoning, Code-Generation, Safety und Vision-Language-Tasks.

Quelle öffnen
How to Evaluate AI Agents From Tool Calls to Task Completion
5 hours ago ... ... updates were skipped. Call ... Gomathy Venkata Krishnan is a developer advocate engineer at NVIDIA responsible for developing deep learning applications.
developer.nvidia.com
KI-Zusammenfassung

Für KI-Agentenentwicklung präsentiert NVIDIA ein Framework zur Evaluierung von Agenten anhand von Tool-Nutzung und Aufgabenvollendung. Der Artikel erklärt, warum moderne Benchmarks von isolierten Funktionsaufrufen zu End-to-End-Aufgabenmessungen übergegangen sind und stellt Metriken wie Task-Erfolgsrate, Tool-Call-Präzision und Argument-Genauigkeit vor. Nemotron 3.5 Lightning erreicht auf PinchBench 86% Genauigkeit und ist 30% schneller als vergleichbare Modelle, mit Reproducibility-Dokumentation und Gewichten auf Hugging Face verfügbar.

Quelle öffnen
ICWE 2026: Best Student Paper Award for HTWK research into AI ...
2 hours ago ... ICWE 2026: Best Student Paper Award for HTWK research into AI-supported assessment of examination performance ... Paper über generative KI-Modelle vom Autorenteam ...
htwk-leipzig.de
KI-Zusammenfassung

Die Publikation „Toward Reliable LLM-Integrated Web Architectures for Teacher-Aligned Automatic Student Grading" von Jonas Gwozdz und Prof. Dr Andreas Both erhielt den Best Student Paper Award der ICWE 2026 in Lyon. Die Arbeit beschreibt eine Architektur, die große Sprachmodelle in Lehrkontexten einsetzt, wobei die Lehrkraft die Kontrolle über die Bewertung behält – das Modell wird systematisch an die Bewertungskriterien des Lehrers ausgerichtet und erreichte in der besten Konfiguration eine Übereinstimmung mit manuellen Bewertungen von etwa 91 Prozent, getestet auf realen anonymisierten Prüfungsdaten.

Quelle öffnen
Über Nacht zusammengestellt von MorningMail.aiZugestellt um 03:10