KI-Entwicklertools · Was kam heute
Für eine erfahrene Engineerin, die ohnehin HN liest. Echte Veränderungen bei KI-Entwicklertools heute: Releases mit Versionsnummern, Paper mit Benchmarks, Repos, die eine relevante Schwelle überschritten haben. Hype-Threads, Pre-Announcement-Leaks und recycelte Zusammenfassungen überspringen. Immer Originalquellen verlinken.
← Zur aktuellen AusgabeQwen3.8 lädt zum Test, Bedrock Agent-Eval, Conductor AI-First
Qwen3.8-Flash-Next verfügbar
Alibabas Qwen-Team stellt die Gewichte zur Verfügung.
Qwen3.8-Flash-Next, die Preview der kommenden Qwen4-Architektur, ist ab sofort zum Testen verfügbar – ein 125-Milliarden-Parameter-Modell mit nur 51 Milliarden zusätzlichen N-Gram-Embeddings für 1-Million-Token-Kontexte [Quelle: NVIDIA]. NVIDIA bietet Day-0-Unterstützung durch SGLang, vLLM und TensorRT LLM an; Benchmarks zeigen 7,6× Speedup beim Prefill bei 1M-Token-Workloads. Entwickler können lokal auf DGX prototypieren oder auf GB300 NVL72 skalieren.
Das ist die Chance, Qwen4 vor dem Release zu testen.
Bedrock AgentCore Evaluation
AWS entkoppelt Agent-Eval vom Framework.
Amazon Bedrock AgentCore Evaluations nutzt OpenTelemetry als Standard-Schnittstelle, um Agenten unabhängig vom SDK zu bewerten – ob LangGraph, LlamaIndex, OpenAI Agents, Claude Agent SDK oder andere [Quelle: AWS]. Das System klassifiziert drei Span-Typen automatisch und nutzt einheitliche Evaluatoren wie GoalSuccessRate und Correctness. On-Demand-Evaluation für CI/CD und Online-Monitoring für Live-Traffic sind beide unterstützt.
Die Framework-Fragmentierung bekommt endlich ein Standardprotokoll.
Conductor: Agents als First-Class
Orchestrierung trennt jetzt Brain von Execution.
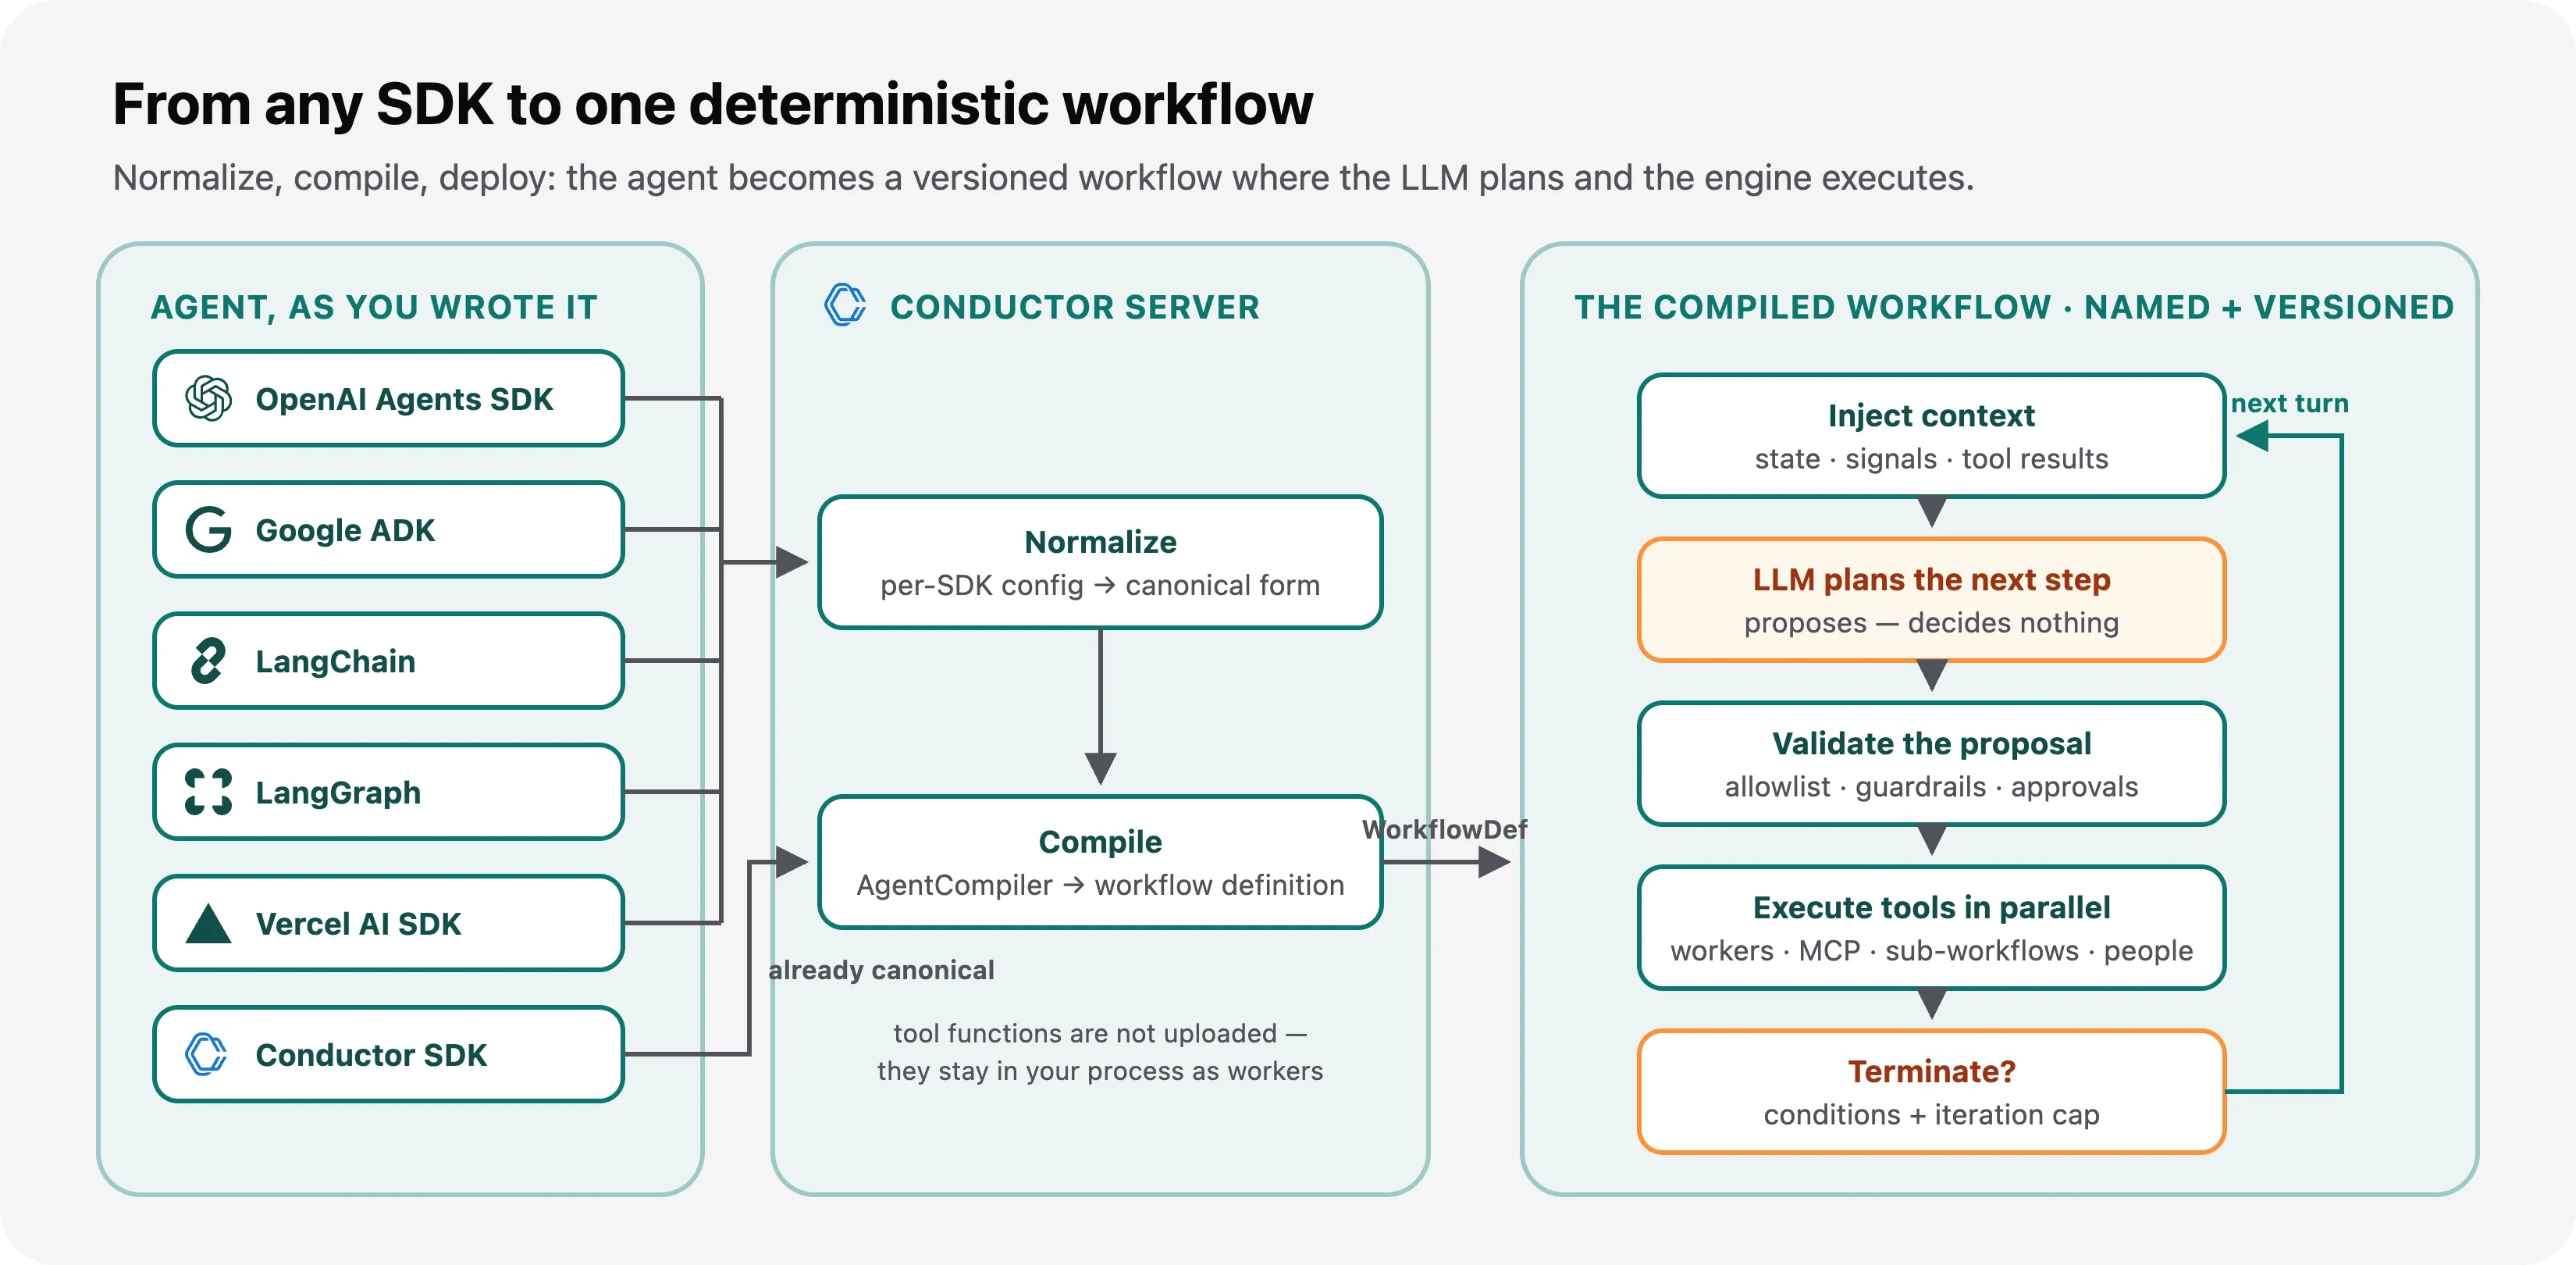
Conductor, das Open-Source-Tool von Netflix, released KI-Agenten als natives Konstrukt – das LLM entscheidet, Conductor führt aus und validiert vorher [Quelle: Orkes]. Agenten von LangChain, LangGraph, OpenAI und anderen kompilieren in durable Workflows mit Built-in Retry-Policies und Determinismus durch kompilierte Guardrails. Die API bietet run() für Entwicklung, deploy() für Versionierung und serve() für Worker-Prozesse.
Reasoning und Ausführung werden endlich architektonisch getrennt.
Anthropic: Start Simple, Skaliere Später
Anthropic dokumentiert, wie Multi-Agent produktiv wird.
Production Agent Performance hängt vom Modell und seiner Harness ab, nicht vom Modell allein – Anthropic empfiehlt, mit einem starken Single-Agent-Baseline zu beginnen und Multi-Agent-Komplexität erst hinzuzufügen, wenn Context-Dilution, Spezialisierung oder Parallelisierung nachgewiesen nötig ist [Quelle: ZenML]. Muster wie Generator–Verifier und Orchestrator–Sub-Agent verbessern Genauigkeit, kosten aber Tokens und Debuggbarkeit. Rapid Prototyping mit Messdaten schlägt lange Planung.
Die Lektion: Architektur wird durch Schmerz, nicht durch Vorhersage getrieben.
 Experiment with Qwen3.8-Flash-Next 176B Model on NVIDIA ...10 hours ago ... Agentic AI / Generative AI | Developer Tools & Techniques | General | Blackwell | NeMo | Intermediate Technical | News | GB300 NVL72 | Mixture of Experts (MoE) ...developer.nvidia.com
 Evaluate any agent framework with Amazon Bedrock AgentCore ...8 hours ago ... And increasingly, they deploy all of these on Amazon ... The OpenTelemetry GenAI semantic conventions define a schema for spans produced by LLM frameworks.aws.amazon.com
 Agents on Conductor — Architecture for Production AI - Orkes16 hours ago ... ... LLM reasons; it does not execute. The LLM reasons, Conductor executes. The ... deploy() registers the agent on the server under a name and a version ...orkes.io
 Engineering Reliable Multi-Agent LLM Systems by Starting Simple11 hours ago ... Anthropic's strategic enterprise implementation work presents a practical framework for deploying agentic LLM systems in production. ... upgrade may change how ...zenml.io